最近在折腾 200P100D 这种大的 PD 分离池,其中就涉及到 DP balance 的方案。
本文主要讨论 Decode 实例内部不同 DP-rank 之间的负载均衡,不展开 Prefill DP、P/D 比例和 EP 专家负载均衡。
个人意见:只看 batch-size 或 context-length 都不够,联合考虑两者效果更好,balance 策略也还有不少挖掘空间。
同步等待的来源
MoE 稀疏化之后,为了提高专家 GEMM 的权重复用和计算效率,需要足够大的全局 batch-size。
以本文的部署配置为例,GLM 5.3 需要 batch-size 达到 2048,才能让 FFN GEMM 算子的 M 平均达到 64;如果用 DeepSeek V4.1 Flash,更是需要达到 4096。
为了装下这么大的 batch-size,通常会用大的 EP + DP,比如 EP64 + DP64。
为了给专家计算组 batch,需要将不同 DP-rank 的 Token 汇聚起来,因此存在同步等待。
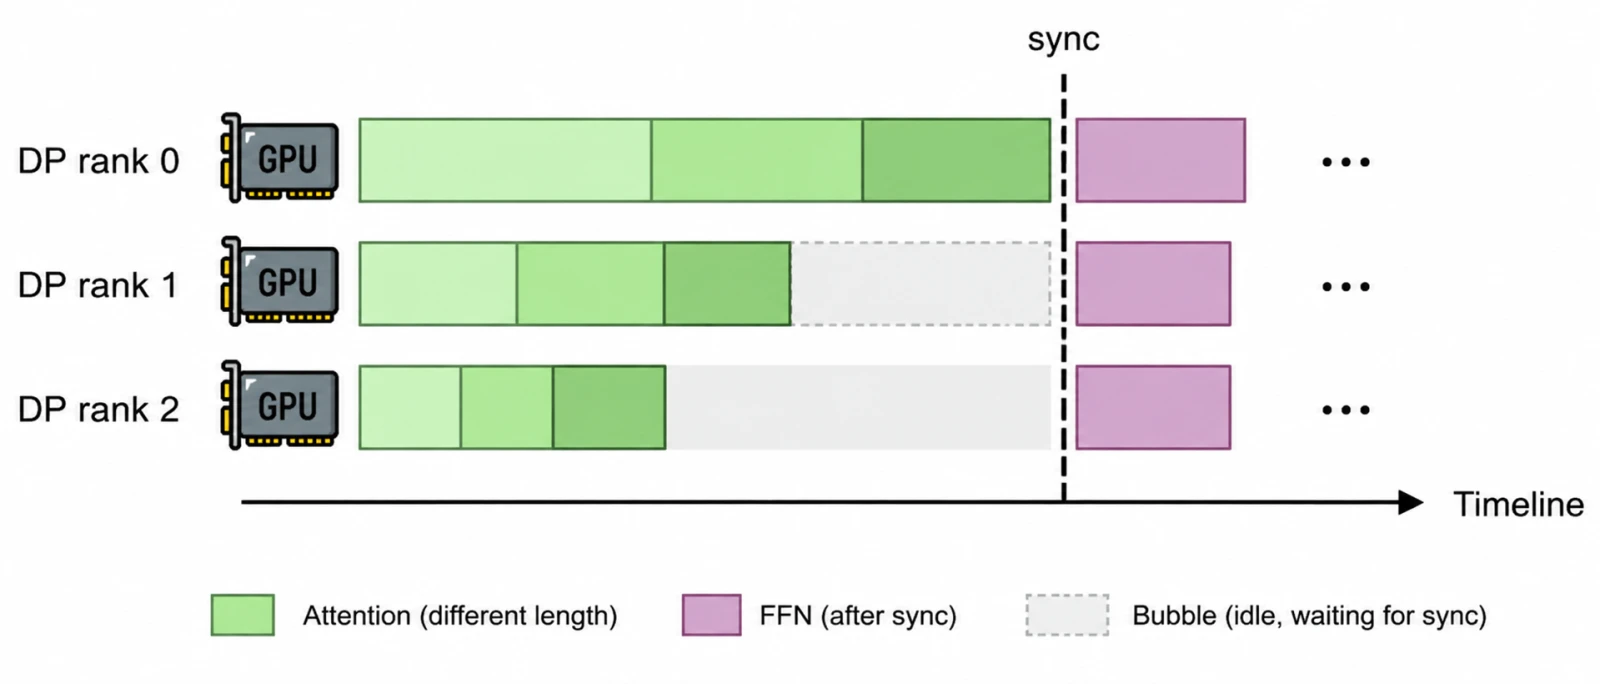
如下简化示意图,如果不同 DP-rank 上的 Attention 计算耗时不同,先完成计算的 rank 就会出现等待 bubble。
如何量化
这是最关键,也是最有挑战的地方(很多优化工作,如果能清晰地量化,基本就成功了一半)。
严格来说,真实推理过程并不像上述简化示意图那样,在 Attention 计算后立刻出现 sync barrier。中间还有 EP 通信,通信量和网络传输可能不同;FFN 计算也会受到 EP imbalance 的干扰。
不过,并不妨碍我们先用 Attention 计算开销建立一个简化模型。在本文讨论的模型和长上下文场景下,Attention 通常是 Decode 计算开销的重要组成部分。
接下来,我们以 GLM 5.3 为例,对 Attention 的计算过程进行拆解。
如下图所示,我们可以观察到:
- Attention 主要有三类计算,分别跟 batch-size 和 context-length 有不同的相关关系。
- 有些计算适合跨请求组 batch,有些则不适合。
- GLM 5.3 的 Attention 层分为 Full Layer 和 Shared Layer,前者包含完整的 Indexer 计算,后者复用 Full Layer 的索引结果,因此两类层的 Attention 开销不同。DeepSeek V4.1 Flash 里也有不同类型的 Attention 层。
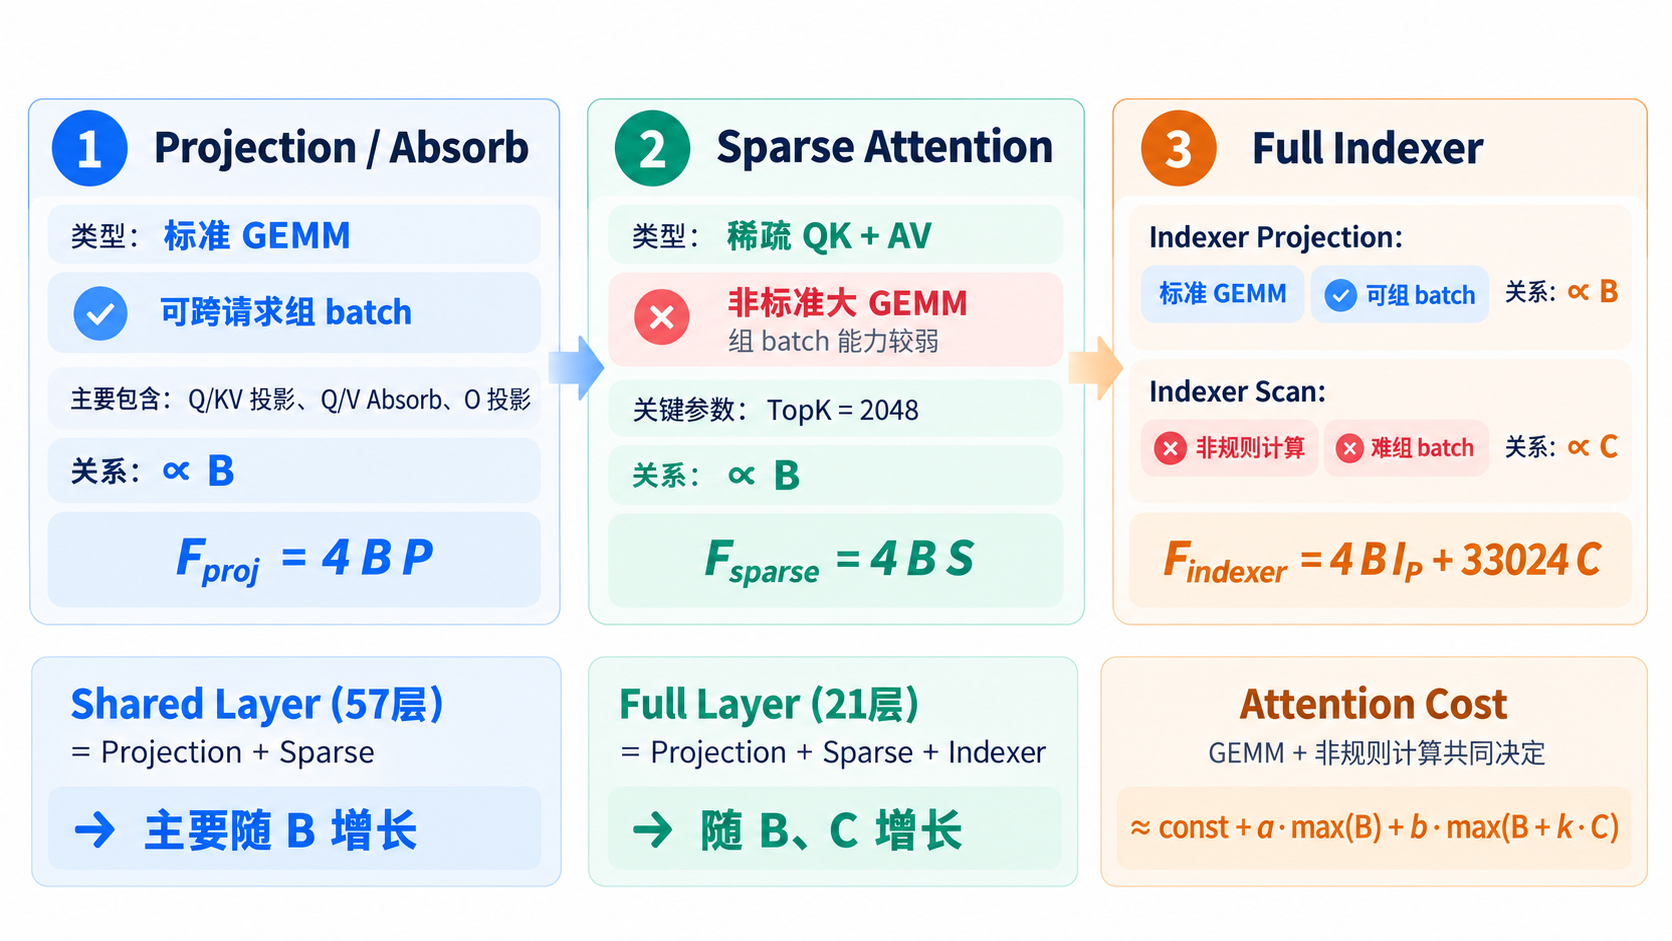
先按照理论 FLOPs 计算相对开销,将图中三类计算按层数加权并归一化,得到 V1:
1 | Attention Cost V1 = 0.72482 * max(B) + 0.27518 * max(B + 1.30219 * C / 100k) |
考虑到小 batch-size 时,GEMM 计算耗时可能近似恒定,因此在 V1 思路上引入固定开销,将 GEMM 的固定成本与其他随 batch-size、context-length 增长的开销分离,得到 V2:
1 | Attention Cost V2 = 4.32158 + 0.336 * max(B) + 0.1238 * max(B + 2.89453 * C / 100000) |
V1 忽略了 GEMM 固定开销,更适合 batch-size 较大、固定开销占比较低的场景;V2 显式引入固定项,用于近似小 batch-size 下的开销。
策略寻优
有了量化,策略寻优就比较好搞了。
首先,我们先定一个理想基线:假设 batch-size 和 context-length 完全均衡,此时得到 Attention Cost 的理论极限。
然后,用生产的 trace 来回放,使用相同的请求序列和 token 容量约束,对这些策略进行对比评估。
- A:选择最小 batch-size 的 DP-rank。
- B:选择汇总 context-length 最小的 DP-rank。
- C:根据请求长短区分,如果长度大于最近 N 条的 Px 百分位,按照策略 A,否则按照策略 B。
原本只做了这三个,最近 DeepSeek 开源的 DeepInfer 提到了另外一个策略,于是又补了一个。
- D:DualPath 算法,按照 DP-rank 的 context/token 容量区分,优先选择 DP-rank token 用量小于
avg * Z的 DP,用 A 策略从其中选;没有符合的 DP-rank,直接用 B 策略选。
当然,每个策略都有 DP-rank 总 token 容量限制的过滤机制,如果 token 容量超限了,会被过滤掉,从剩余的 DP-rank 中选择。
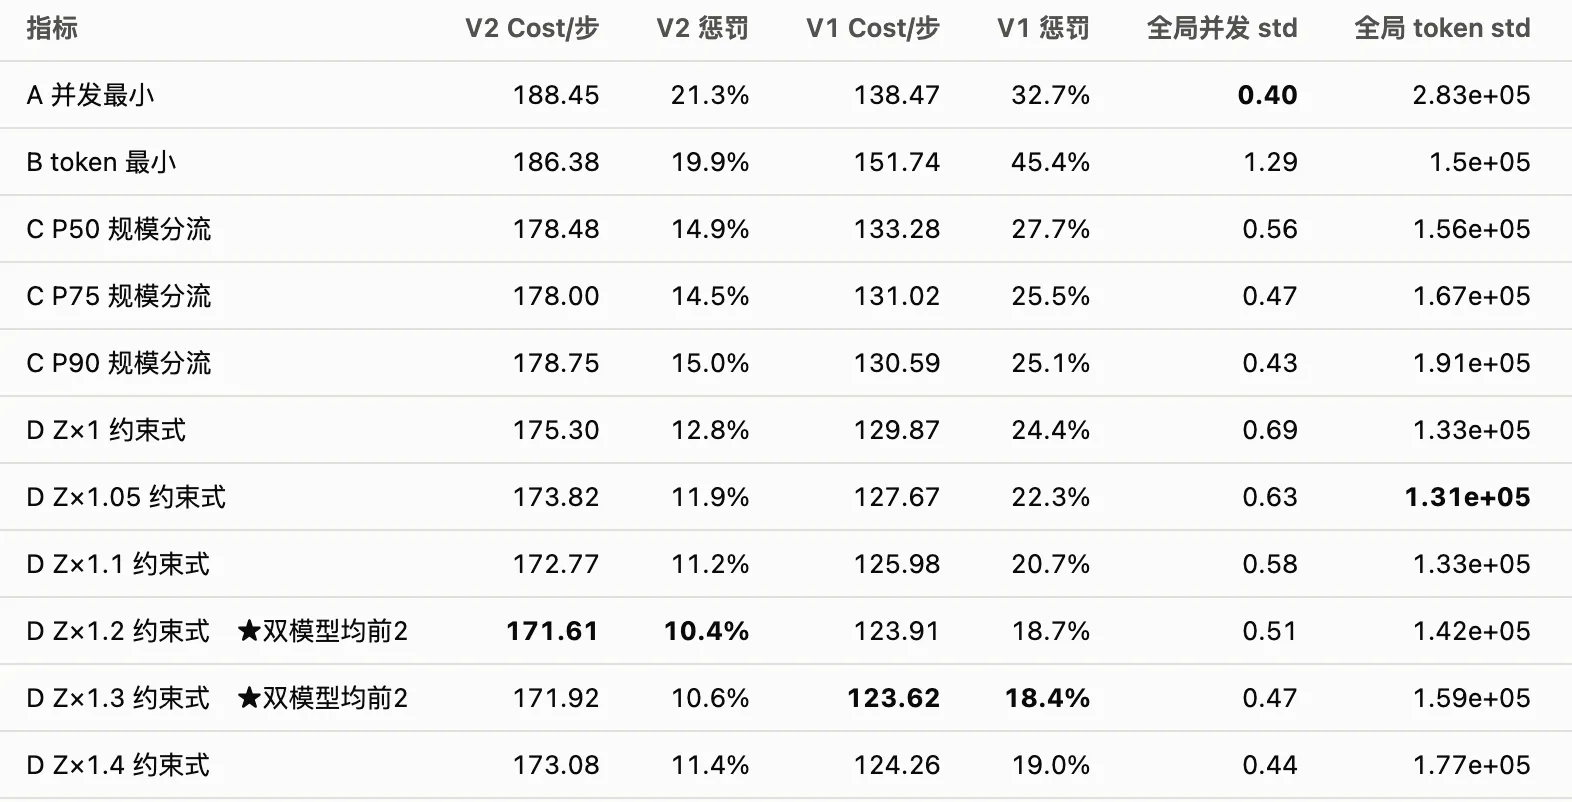
由图可见:
- 单看 batch-size(A)或者单看 context-length(B),效果都不够理想。
- 简单做个长短区分(C),效果要好不少。
- 在本文对比的这些策略中,DualPath 的整体表现最好。其中,
Z = 1.05对应的 token 负载最均衡,Z = 1.2 / 1.3对应的 Attention Cost 更低。DualPath 论文 中使用的是Z = 1.05,DeepSeek 线上生产环境用什么值,没有公开,我估计不是 1.05。 - 即使同样是 DualPath,对应
V1/V2两种 Cost Model,表现最好的超参也略有差异:分别是Z = 1.3和Z = 1.2。
分组影响
另外,关于路由策略分组的影响,也做了一组对比分析。
比如按照 DualPath 里的策略,对一批引擎划分不同的组,先选组,再从组内选 DP。
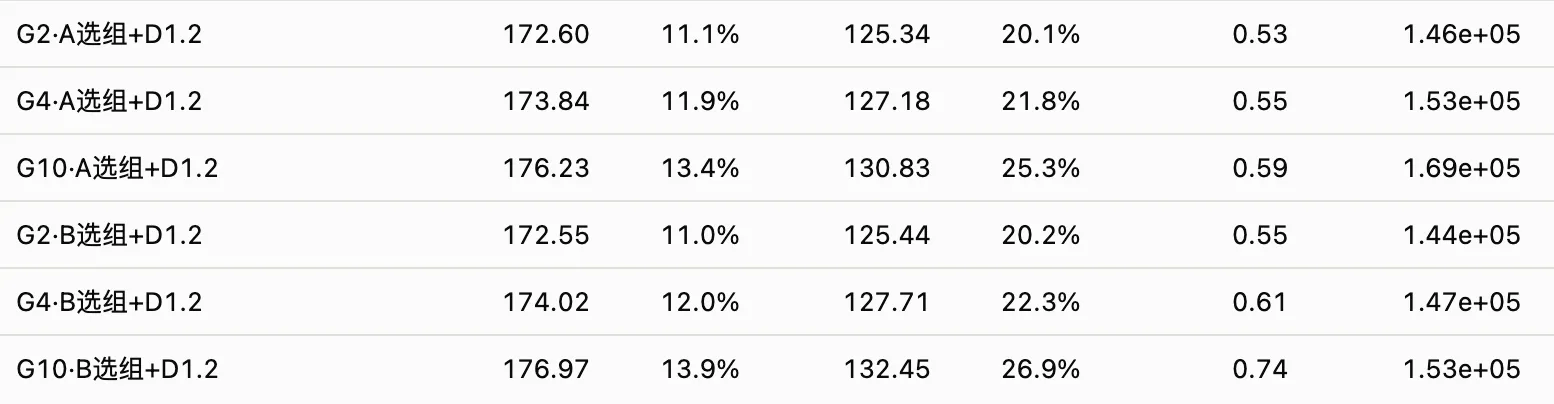
这里综合两种 Cost Model 的结果,选择策略 D,并固定 Z = 1.2,搭配不同的分组数量(2、4、10)和选组策略(A、B)。
对比结果如图可见,在本次实验配置下,分组数量越多,模型评估的负载均衡效果越差。这也比较符合直觉:分组越多,每个组内的候选 DP-rank 越少,请求调度的寻优空间也越小。
当然,池子越大,工程挑战也越大,这个跟当前折腾的大 PD 池是一样的挑战。
实际测试
上面只是基于 Cost Model 的离线寻优,真实效果如何呢?这里又有很多前面提到的干扰项。
这是针对小规模场景 DP8 的真实推理回放结果:
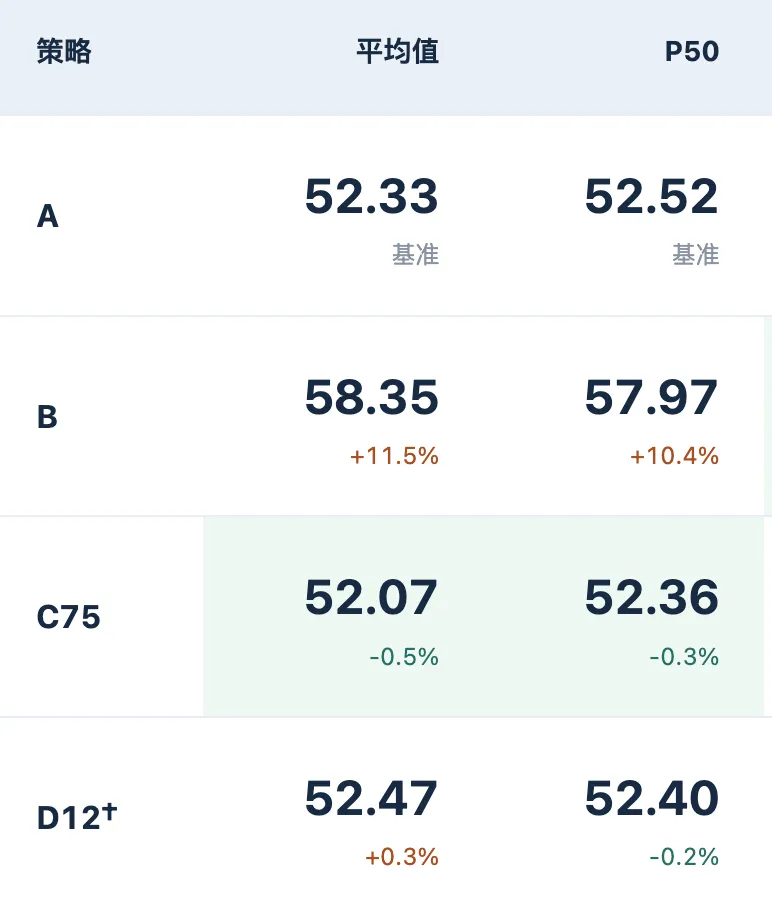
本次测试中,A、C、D 的差异很小,尚不足以判断优劣;B 的时延则明显高于其他三种策略,时延平均值和 P50 相比 A 分别增加了 11.5% 和 10.4%。
因为只有一个 DP8 实例,这种小规模测试还难以体现策略在大规模 DP 下的差异,也需要更多重复实验来确认微小差异是否稳定。后面有时间再做大规模的测试验证了。
Cost Model
看起来模型评估和真实推理仍有一定差异。除了规模大小,差异还可能来自 Cost Model 的误差、EP 通信、EP imbalance 等因素。
讲道理,做 SLO-aware routing 的时候,我们也对 Prefill / Decode 做过 Cost/Latency Model。
Prefill 相对好做一些,这次 DeepSeek 也放出了不少信息(用于 Prefill 阶段的 DP balance),其中的 Model 部分,跟我们做的思路一样。
Decode 则比较难做,尤其是 Attention Cost 只是其中的一部分。这次 DeepInfer 的公开材料没有给出 Decode Attention Cost Model,本文也是用简化模型近似。
不过,我还是觉得这是可以做出来的,或早或晚的事,看是我们先做出来,还是 DS 先分享出来。
未来畅想
首先,DP balance 大概率会长期存在,只是 imbalance 的代价不同,或许会变小。
即使后面演进成 DP、EP 分离,分别做成不同的 microservice,走异步流程,不同 DP 之间还是需要有 balance 的(近一两年,做成这么理想的 microservice 我觉得还是比较难的)。
那么,如何解决呢?
首先还是 Cost Modeling 需要有,这样从路由层面可以让 DP 尽量均衡。当前 DualPath 中的启发式算法,我判断并不是最优解,应该还有提升空间。
但是路由是请求粒度控制的 Balance,终究是有个度的。可能在 DS 那种单 DP-rank 的 batch-size 达到 100+ 量级的场景,这个上限已经比较高了,没准也够用了。
如果不够用,也可以参考 DS 解决 Prefill DP 的思路,在引擎侧以 Token 粒度来控制。
Prefill 可以动态调整 chunk-size,类似的,Decode 也可以动态调整投机 Verify 长度:给较快的 DP-rank 分配更多 Verify 计算,利用原本可能空闲的时间,同时控制较慢 rank 的计算量。
目标不是单纯为了对齐而增加计算,而是在有效吞吐和 DP 等待之间寻找更好的平衡,本质上跟 DSpark 思路是一样的。
当然,前提还是 Cost Model 有足够精确度。
最后
DeepSeek 这次还是分享了不少好东西,也侧面验证了我们在 Cost Model 的工作方向是很有价值的,向 DS 老师学习。
比如进一步的存算分离,把 KVCache 做成独立存储服务。上一篇分享过存算分离,这次 DS 就放出了更多细节,虽然 DS 这么做并不意外。
还有 Balance 工作也很细致,Prefill 的 DP balance 我认为做得挺细致了,Decode 的 DP balance 估计还有挖掘空间。DeepInfer 文档 提到,线上整体负载均衡效果约为完全均衡离线基准的 80%(这个口径并不只针对 Decode DP,但也说明真实流量下,负载均衡依然值得持续优化)。
下次,或许可以分享下如何做 Cost Model,比 DS 老师的细节更具体一些。