有了全局 KVCache 池化,比如 Mooncake Store,因为可以跨机复用 KVCache,Prefix KVCache 命中率,很大程度上取决于 KVCache 的缓存容量
网关路由不需要被 KVCache 命中率束缚,如上一篇算过 KVCache 传输开销,只需要倾向性的提高 Local KVCache 命中率,属于进阶的优化工作
今天来分析下,KVCache 缓存容量到底需要多大,以及有哪些优化方向
capacity => TTL => Hit Rate
因为可以跨机 KVCache 传输,只要 KVCache 没有被淘汰,就可以被复用
而是否已经被淘汰,主要取决于 capacity,理论上容量越大,越不容易触发淘汰
本质上是这样的推导关系:capacity => TTL => Hit Rate
Agentic trace
接下来我们基于一份 Agentic 场景的 trace,一整天的数据,来进行分析
不同业务场景的定量数据会有不同,但是大致的定性结论还是基本一致的
这份 trace 有一段时间了,KVCache 命中率比最新的 trace 会略低一些,不过,并不影响定性的分析
TTL vs Hit Ratio
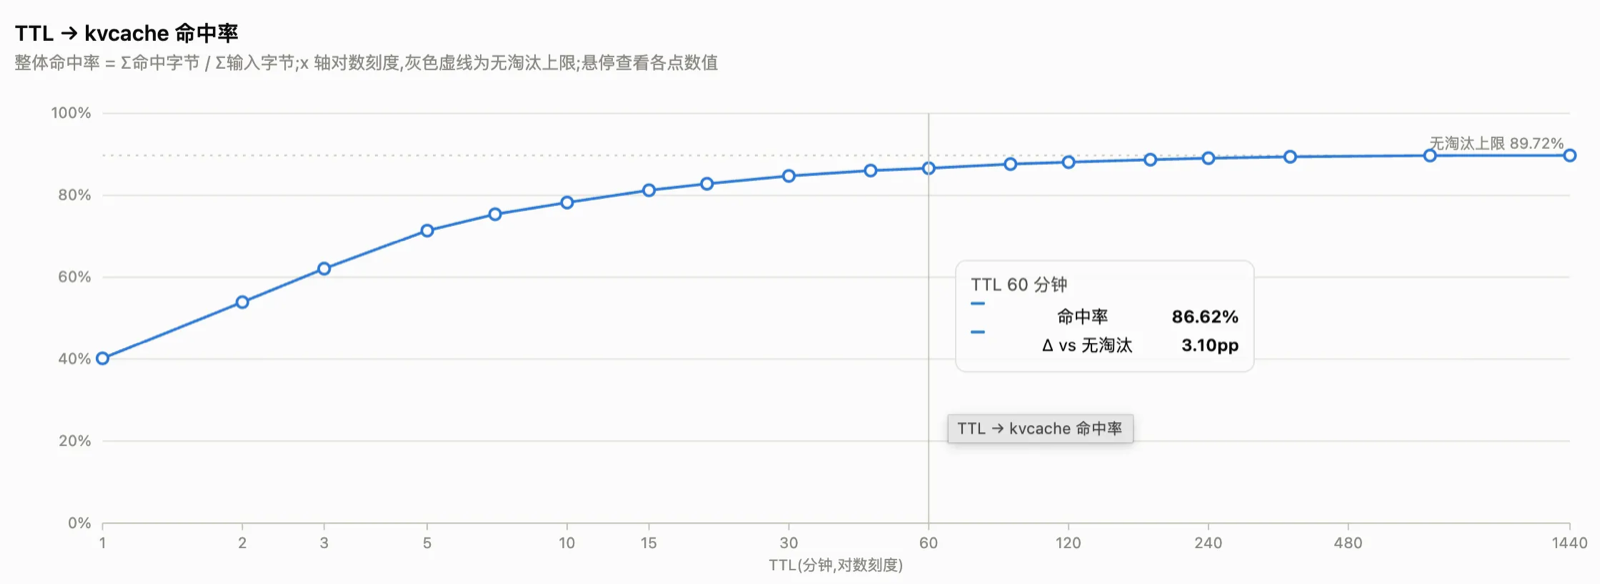
跟命中率最直接相关的是,TTL,也就是 KVCache 在缓存里实际存活的时间(以上次被使用的时间作为起点)
由图可见:
- KVCache 命中率有理论上限(假设完全没有淘汰),这里的理论上限是 89%
- TTL 变长的收益是边际递减的,比如 TTL 到 1 小时的时候,只比理论上限低 3 个百分点
TTL vs capacity
计算容量,跟 KVCache 的淘汰策略是强相关的
这里我们考虑了两种淘汰策略:
- 常规的 LRU:淘汰的时候,统一按照存活时间来,老的先淘汰
- 理论上限:事后的上帝视角,后续不需要的先淘汰,然后再按照常规 LRU 策略来淘汰
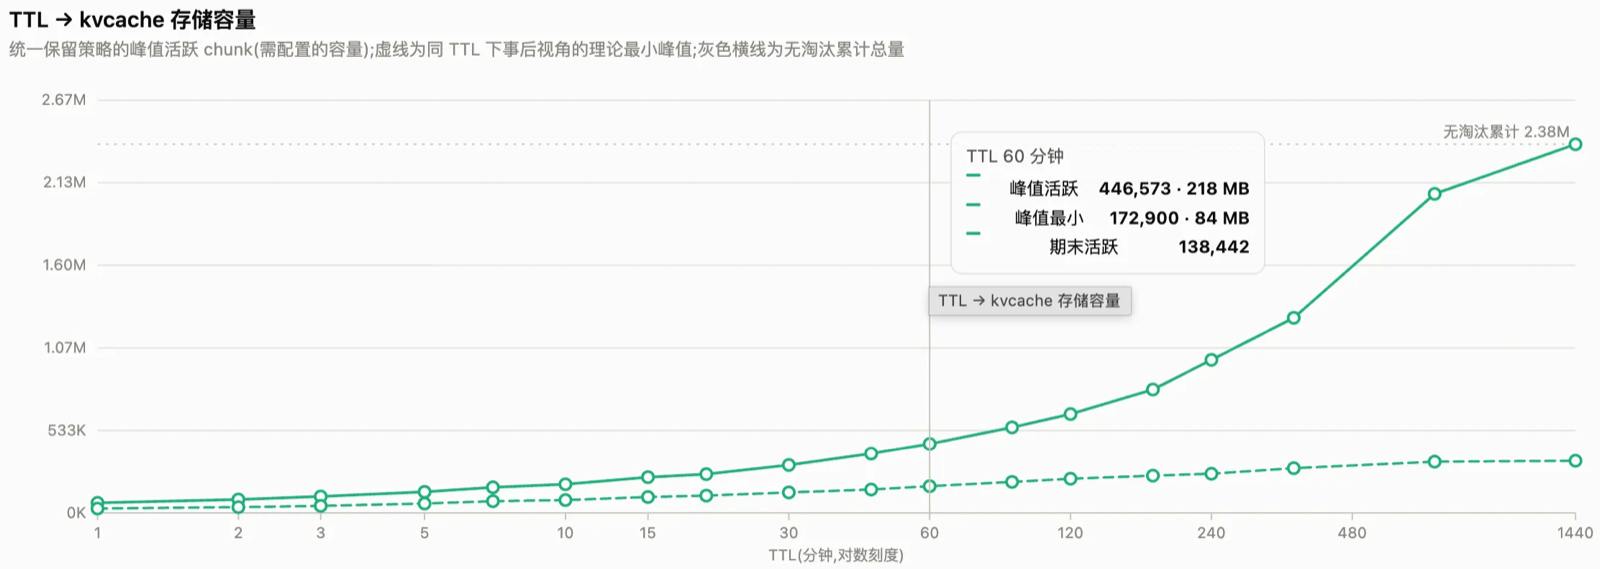
由图可见:
- TTL 越长,容量会明显上涨
- 理论上限比常规策略,明显的低不少
这里可以衍生两个推论:
- capacity 并不是越大越好,虽然 GPU 计算是挺贵,但是存储也是要花钱的,顶不住边际递减的收益,这里有一个盈亏平衡点,是可以算出来的
- 常规的 LRU 策略肯定不是一个好策略,跟理论上限有较大的差距
淘汰策略优化
为了更直观的对比淘汰策略,我们用上图的两个容量做个对比
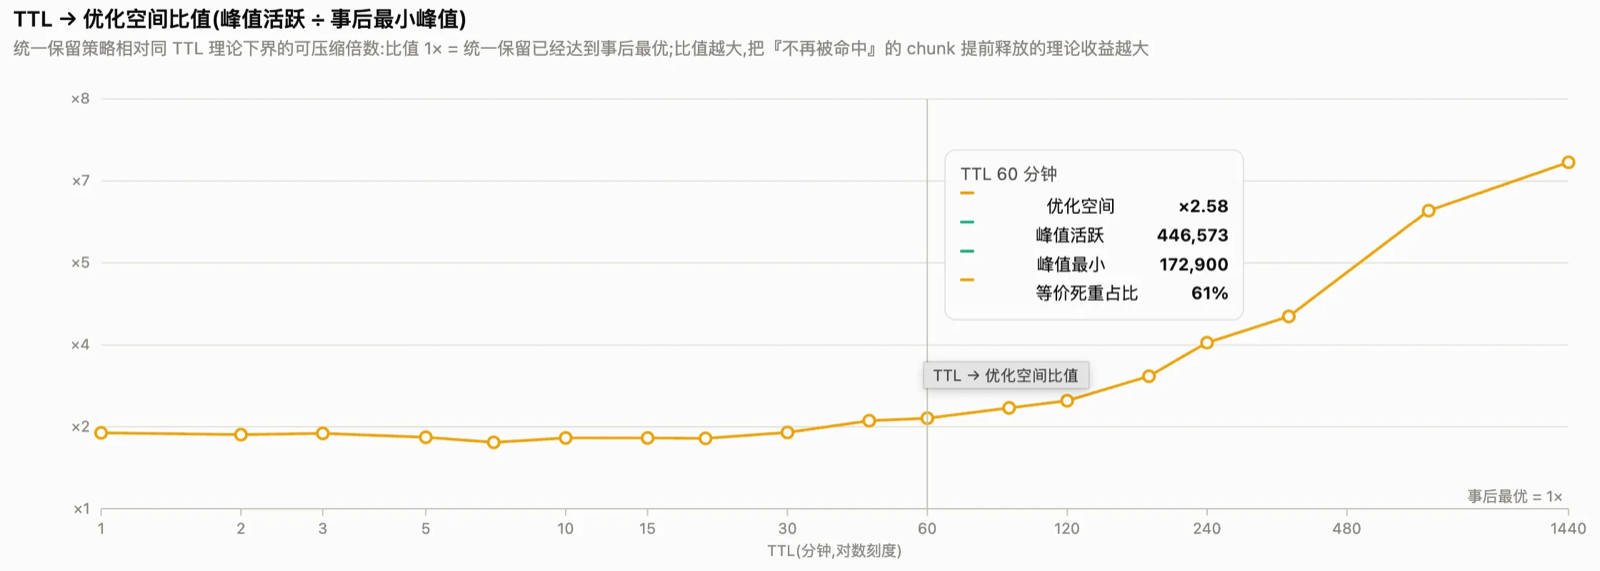
由图可见:
- 大部分 TTL 场景下,常规的 LRU 策略,占用的空间是「理论上限」的两倍
- 并且,TTL 越长,这个倍数还会更大,可以增长到 5-7 倍
因此,我的推论是,优化下淘汰策略,比扩大容量更有性价比(当然,容量得先到了一定量级,比如能支持 TTL 到达 1 小时的)
比如优化方向:
- Agentic hints:根据 Agentic 带过来的业务场景信息,动态设置 KVCache 的 TTL 上限
- 主动 KVCache TTL 管理:比如 session 结束,主动触发 KVCache 淘汰
存算分离
这可以算更长远的方向预判
当前的 KVCache 缓存,主要还是利用 GPU 节点上原有的 HBM、DRAM 资源,多一点就再加上 SSD 资源
也就是计算和存储是同步绑定扩缩容的,比如 GPU 节点的 DRAM 配置也不小,不用也浪费
把 KVCache 存储独立出来,做成独立可伸缩的缓存服务的,估计还不多
依我之见,这个应该是未来比较有希望的一个方向
不过,我的判断这个也是进阶型的,算不上强优化需求,因为当前主流场景下,HBM + DRAM 的存储空间已经足够大了,这个独立化的缓存服务在扩大容量上来说,优化效果不是很大了
独立服务最大的好处,还是计算和存储可以独立的扩缩容,可以更大范围内、更好的利用存储容量
最后
总结一下,KVCache 缓存需要多大的容量空间,能提供多少的缓存命中率,这个是可以根据请求 trace 回放统计出来的
优化的方向上,KVCache 淘汰策略是挺值得搞的,存算分离也是值得长期跟进的
今儿这个,主要是从整体上做一些粗粒度的分析,比如存储全部归一化为容量了
实际上,HBM/DRAM/SSD 是多级存储结构,这里分级的命中率,也是有很多深挖的细节的